

えだまめ
2026-08-28
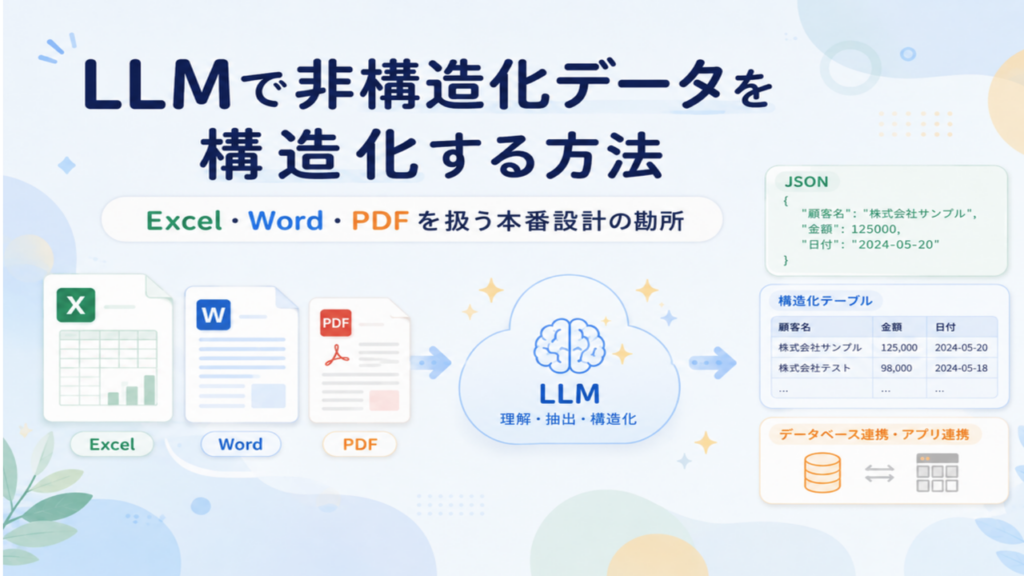
LLMによる文書構造化は「ファイルを渡してJSONを返させる」だけでは本番運用できません。入力の正規化、出力スキーマ、後段検証、人間レビューを一つのパイプラインとして設計することが重要です。
なぜLLMによる構造化が重要なのか
業務システムやデータ基盤の現場では、データがExcel、Word、PDFのまま蓄積され、後続処理で使える形になっていないことが珍しくありません。
同じ請求書でも、取引先ごとに「請求額」「合計金額」「ご請求金額」と表記が異なり、値の位置や明細列も一定ではありません。Excelでは担当者が行を追加したり、セルを結合したりするため、同一テンプレートでも構造が変わります。
従来は、帳票ごとに座標指定、正規表現、ETL処理を作り込んでいました。しかし、帳票種類と改版が増えるほど個別ルールの保守が追いつかなくなります。
LLMは、ラベルと値の意味関係を読み取り、異なる表現を共通スキーマへ対応付けられる点が強みです。ただし、本番で必要なのは「おおむね取れる」ことではなく、誤りを検知し、処理できない入力を安全に例外へ送れることです。
LLMで構造化する典型的なアプローチ
代表的な方式は、原文から目的のJSONを直接生成する方式と、いったん中間フォーマットへ正規化してから抽出する方式です。
直接JSON抽出は構成が単純で、項目数の少ない定型文書に向きます。一方、複数シートのExcelや段組みされたPDFでは、Markdown、CSV、レイアウト付きJSONなどの中間表現を作った方が、見出しと値の関係を保ちやすくなります。
本番では、日付変換や空行除去など決定論的に処理できる部分をコードへ寄せ、項目の意味判定だけをLLMに任せるハイブリッド方式が扱いやすいです。LLMの前後を含めて一つの抽出パイプラインとして設計します。
| 方式 | 特徴 | 向いているケース |
|---|---|---|
| 直接JSON抽出 | 文書から目的スキーマへ直接変換する | 単純な定型文書、項目数が少ない処理 |
| 中間フォーマット経由 | 表や段落をMarkdown、CSV、独自JSONへ正規化する | 複数表、複数ページ、複数シートの文書 |
| ハイブリッド | コードで確定できる処理と、LLMによる意味判断を分離する | 本番運用、大量処理、監査が必要なシステム |
構造化パイプラインの基本形
入力をそのままLLMに渡さない
Excelの難しさは、見た目が表でも、内部構造が必ずしも一つの表ではない点にあります。セル値だけを左上から並べると、見出しの階層や注釈との関係が失われます。
- 「株式会社A」「(株)A」などの表記ゆれ
- セル結合による階層見出し
- 一つのシートに複数の表が存在する構成
- 月別・部門別に分割された複数シート
- 非表示行、色、位置によって表現された意味
- 数式セルの計算式と画面上の表示値の違い
前処理では、シート名、セル座標、結合範囲、行列見出し、表の範囲を取得し、「どの値がどの見出しに属するか」が分かる中間表現へ変換します。抽出結果には、source_sheet、source_cell、source_pageなどの参照元も残します。
Wordでは本文、表、ヘッダー、脚注を分け、PDFではテキスト層の有無、段組み、表、画像を確認します。レイアウトが意味を持つ文書は、単純なテキスト抽出ではなく、座標情報やページ画像を利用する設計が必要です。
重要なのは全ファイルを同じ方法で処理しないことです。文書種別を先に分類し、種別ごとに前処理を切り替える方が、精度とコストを制御しやすくなります。
Excelを中間フォーマットへ変換するイメージ
ここでいう中間JSONは、最終的に業務システムへ登録するJSONとは役割が異なります。元のExcelにあったシート名やセル範囲、見出しと値の関係を、LLMが扱いやすい形へ整理した中間表現です。
例えば上図では、「請求情報」シートのB4:F12という範囲に「請求額」という項目があり、その値が「120,000」である、という関係を保持しています。実際の実装では、必要に応じてセル座標や結合範囲などのメタデータも追加します。
出力スキーマを固定する
プロンプトに「JSONで返してください」と書くだけでは、キー名の揺れ、必須項目の欠落、型の不一致を防げません。後続アプリケーションが期待する形式をJSON Schemaとして先に定義します。
Structured Outputsのようにスキーマ準拠を制約できる機能が利用可能なら、必須項目、型、enum、null許容、追加プロパティの可否をAPI側で固定します。未記載の値は推測させず、nullを返せる設計にします。
| 設計項目 | 考え方 |
|---|---|
| 必須項目 | Structured Outputsでは定義した全項目を required にする。値が存在しない可能性がある項目は null を許容する |
| null | 不明値を推測で埋めず、明示的に許容する |
| enum | 区分値や通貨コードなど、候補が決まっている値を制限する |
| 追加プロパティ | 想定外のキーを受け入れるかどうかを明示する |
| 根拠情報 | source_refやsource_textを持たせ、抽出元を追跡できるようにする |
ただし、スキーマに準拠したことと、値が業務的に正しいことは別です。amountがnumber型でも、請求額ではなく税額を抽出していれば誤りです。形式保証と意味保証を分けて考えます。
LLMの後段に検証処理を置く
LLMの出力をそのままDBへ登録せず、決定論的なバリデーションを必ず通します。
- JSON Schemaによる型・必須項目チェック
- 日付、郵便番号、コード体系などの形式チェック
- 明細合計と請求合計などの項目間整合性チェック
- 取引先、商品、部門などのマスタ照合
- 異常値や欠損値の検知
エラーは単に再試行するのではなく、schema_error、master_not_found、total_mismatchなどの理由コードへ分類します。理由が分かれば、再抽出すべきか、人間へ回すべきかを制御できます。
また、LLM自身に出させた信頼度だけを判定基準にするのは危険です。ルール検証の結果、項目の重要度、過去の誤り傾向などを組み合わせてレビュー対象を決めます。
自動処理と人間レビューの分岐
特に金額、契約条件、顧客情報など、誤りの影響が大きい項目では人間レビューを残す方が安全です。100%自動化ではなく、正常系の大部分だけを自動化するという考え方が現実的です。
PoCはできても本番化で詰まりやすいポイント
LLMによるデータ抽出は、代表的なファイルを使ったPoCでは高い精度が出ることがあります。しかし、本番データを流し始めると、精度以外の問題も表面化します。
1. 想定外の帳票が必ず混ざる
PoCでは代表的な帳票を選びますが、本番では旧版、手修正されたExcel、途中に別表が追加された文書が流入します。平均精度だけでなく、未知フォーマットを検知して止められるかが重要です。
2. 正解データの維持がボトルネックになる
モデルやプロンプトを変更したとき、改善したかを判断するには正解付きの評価データが必要です。文書単位の成功率だけでなく、項目単位の正解率、欠損率、誤った自動登録率を測ります。
帳票の追加や改版に合わせて評価データも更新し、変更前後を同じデータで回帰テストできるようにします。これがないと、一部を改善した結果、別形式の精度を落としても気づけません。
3. 精度以外の運用要件が効いてくる
大きなファイルを毎回そのまま渡すと、処理時間とAPIコストが増えます。不要シートやページの除外、同一ファイルの重複処理防止、失敗時の再実行単位を設計します。
また、モデル、プロンプト、スキーマのバージョンを記録し、同じ入力を再処理できるようにします。本番では「なぜこの値になったか」を追跡できることが、精度と同じくらい重要です。
導入時の設計ステップ
導入検討時の進め方
入力を棚卸し
帳票種類、改版、例外パターン、月間処理量を把握します。
中間表現を決める
レイアウトと参照元を失わない正規化形式を設計します。
スキーマと検証を作る
型、業務ルール、マスタ照合、理由コードを定義します。
例外運用を作る
人間レビュー、再処理、監視、評価更新を業務フローへ組み込みます。
最初から全帳票を対象にするのではなく、入力パターンが比較的安定し、誤りの影響を制御しやすい業務から始めます。自動化率だけでなく、レビュー削減時間と誤登録率をKPIとして確認します。
| 観点 | 本番化前に確認したいこと |
|---|---|
| 入力 | 未知形式を検知し、安全に停止できるか |
| 前処理 | レイアウトと参照元を保持しているか |
| 出力 | JSON Schemaで形式を固定しているか |
| 検証 | 業務ルールとマスタで値を確認しているか |
| 評価 | 項目単位の正解データと回帰テストがあるか |
| 例外 | 人間が根拠を見ながら修正できるか |
| 運用 | モデル、プロンプト、スキーマを追跡できるか |
まとめ
LLMは、書式が統一されていないExcel、Word、PDFから意味を読み取り、共通スキーマへ変換する有力な手段です。
一方、LLMだけで品質を保証することはできません。入力の正規化、スキーマ固定、ルール検証、評価データ、監査ログ、例外処理まで含めて初めて本番システムになります。
特に重要なのは、「LLMに何を任せないか」を決めることです。コードで確定できる処理はコードへ寄せ、LLMは意味判断へ使い、判断不能なデータは人間へ戻します。
目指すべきなのは100%の無人化ではありません。誤りの影響とレビューコストを見ながら、どこまでを自動化し、どこから人が介在するかを明確に線引きすることが、安定運用への近道です。


