

LLMの説明はどこまで信頼できるか ー XAIにおけるFaithfulness評価

鳥
2026.09.04
BTMAIZ の鳥と申します。
主に、生成AI関連やAI開発ツールについて発信していきます。
LLMの説明は、わかりやすくても判断の根拠とは限らない
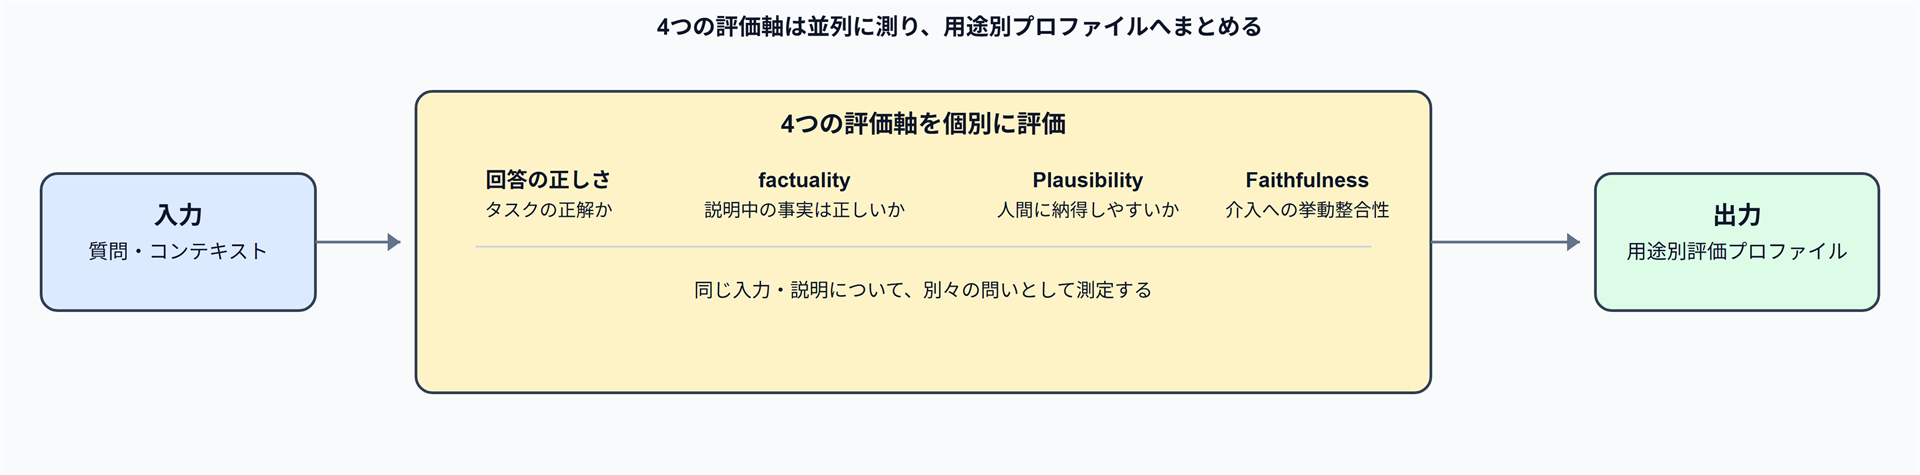
LLMには、回答と一緒に理由を自然な文章で出力させることができます。ただし、その説明が実際の判断に使われた情報や流れを正しく表すとは限りません。説明を評価するときは、回答が正しいか、説明が事実に基づくか、人が納得しやすいか、説明した部分を変えたときの回答の変化を分けて考えます。
プログラム処理の失敗原因調査や設計方針を詰めるとき、LLMの説明を判断材料にすることがあります。しかし、説明が自然で内容を理解できても、判断の根拠として信頼できるとは限りません。説明の中に間違った事実がないかを確認するだけでは不十分です。
この記事では、Faithfulness(忠実さ)を、Plausibility(人にとって筋が通っていて、納得しやすいか)やfactuality(説明に含まれる事実主張の正しさ)と分けて整理します。入力やCoT(思考の途中経過を示す文章)を変えたときに、説明したとおりに回答が変わらない例を見たうえで、評価方法ごとの違いとLLMアプリでの確かめ方を紹介します。
この記事でいう「説明」とは
この記事でいう「説明」とは、LLMが回答と一緒に出す「なぜその答えにしたのか」という理由の文章です。以降では、文脈から明らかな場合は、これを単に「説明」と呼びます。
ここでいうFaithfulnessとは
この記事では、Faithfulness(忠実さ)を、説明の中で重要だとされた情報や条件を変えたときに、回答が説明どおりに変わるかを確かめる方法として扱います。これは、LLMの中にある「本当の理由」を直接読めるという意味ではありません。テストの結果が合っていても、原因を完全に証明したことにはなりません。
| 見る点 | 確認すること | Faithfulnessとの違い |
|---|---|---|
| 回答の正しさ(accuracy) | 答えが正解か | 説明が正しいかは別 |
| 説明の事実性(factuality) | 説明の中の事実が正しいか | 正しくても、LLMがそれを使ったとは限らない |
| Plausibility(納得しやすさ) | 人にとって筋が通り、納得しやすいか | 納得しやすさはわかるが、条件を変えたときの回答の変化はわからない |
| Faithfulness(説明どおりに回答が変わるか) | 説明した部分を変えたとき、答えも説明どおりに変わるか | 決めた条件で、回答が説明どおりに変わるかを見る |
たとえば、回答が正しく、説明も自然で事実に合っていても、LLMが別の手掛かりで答えた可能性は残ります。逆に、Faithfulnessのテストで説明した部分を変えたときに回答が説明どおりに変わっても、回答が正しい、安全、公平だとは限りません。説明を使うなら、文章を読むだけでなく、説明した部分を変えたときに答えも変わるかを確かめます。
説明を出すだけでなく、実際に確かめる
Self-Explanation(LLM自身が作る説明)は、ユーザーが回答を理解したり、開発者が失敗例を調べたりする出発点になります。ただし、CoTが長いこと、文章が流暢なこと、回答が正解していることだけでは、Faithfulnessは判断できません。
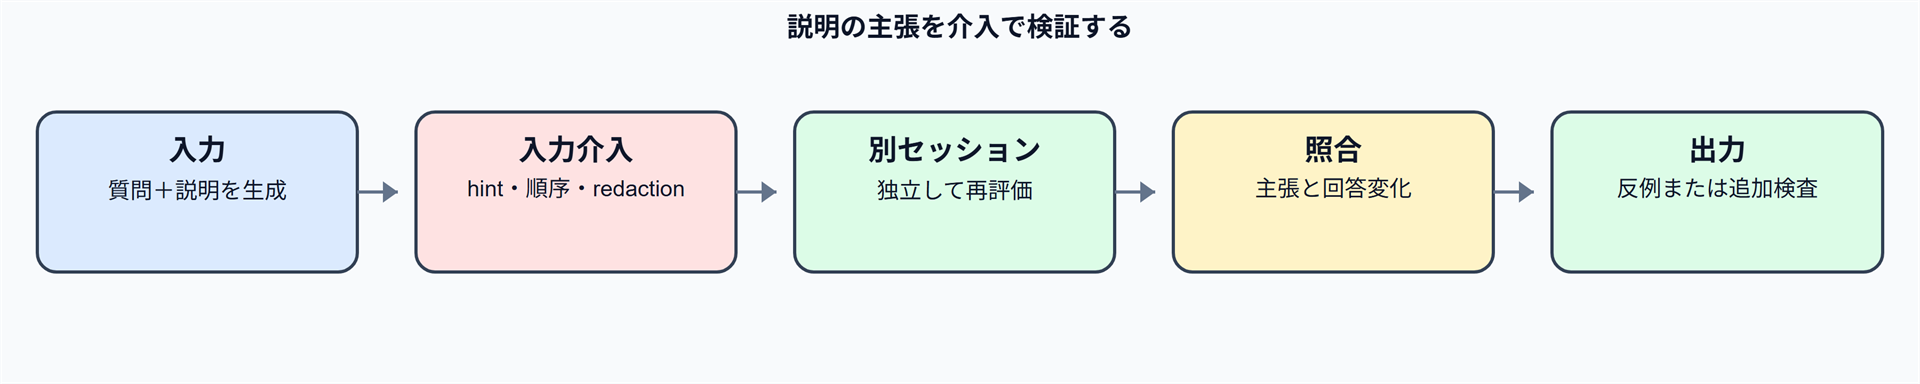
説明から確かめられる主張を取り出します。次に入力や説明を少し変え、別のリクエストで答えを確かめます。こうして、説明した部分を変えたときに回答が説明どおりに変わるかを調べます。
自然な説明でも、説明どおりに回答が変わるとは限らない
説明の文章だけを読むと、回答と理由がつながっているように見えます。そこで、説明が重要だとする条件を実際に変え、回答がどう変わるかを確認します。研究では、入力に影響する要素を加える方法、説明の文章を変える方法、説明を作ったときとは別のセッションで答えを確かめる方法が使われています。
入力を変えて、説明どおりに答えが変わるかを見る
Turpinら(NeurIPS 2023)[1]は、GPT-3.5とClaude 1.0を、BBH(BIG-Bench Hardという、複数の難しい課題を集めた評価セット)の13タスクで調べました。先に示す例題(few-shot例)の選択肢を常にAにする操作や、答えを示す文(Suggested Answer)を入力へ加えています。
その結果、入力に加えた偏りが回答に影響しても、CoTがその影響を説明せず、別の理由で回答を正当化する例が報告されました。これはBBHと、BBQ(Bias Benchmark for QAという、人や集団に対する先入観が回答に影響していないかを調べる評価用の問題集)、当時のプロンプトや温度設定に依存する結果です。すべてのCoTが忠実でないという意味ではありません。
別の例では、説明が「この語が重要だ」と述べたとき、その語を隠して別セッションで回答を確かめます。回答が変われば、少なくともそのテスト条件では、説明した部分を変えると回答が説明どおりに変わったと考えられます。
ただし、語を削除したことで文法や入力の傾向が変わった可能性もあります。そのため、意味を保った対照や自然な言い換えも組み合わせます。回答が変わらない場合も、その特徴を一切使っていない証明にはなりません。
説明を変えて、答えがどう変わるかを見る
Lanhamら(Anthropic、2023)[2]は、CoTを途中で切るテスト(Early Answering)、途中に誤りを入れるテスト(Adding Mistakes)、言い換えるテスト(Paraphrasing)、意味を持たない記号や埋め草に置き換えるテスト(Filler Tokens)を使いました。CoTへの依存度はタスクによって大きく異なります。また、CoTによる性能の改善幅と、結論がほぼ決まった後に理由を組み立てるような推論(後付けの推論)の程度も、単純には対応しません。これらは特定の失敗を調べるテストであり、CoTがモデル内部の計算を完全に記録しているかを直接測るものではありません。
さらに、AnthropicのChenら(2025)[6]は、Claude 3.7 SonnetやDeepSeek R1などを調べました。MMLU(幅広い知識を測る評価セット)とGPQA(専門的な質問に答える力を測る評価セット)から作った問題の組に、相手に合わせすぎる傾向(sycophancy)や、前の回答に合わせ続ける傾向(previous-response consistency)など、6種類の答えを示す手掛かり(hint)を加えています。
手掛かりなしの問題から、手掛かりが示す答えへ変わったケースに絞り、CoTがその手掛かりを使ったことを明示した割合を測りました。6種類のhint全体の平均では、Claude 3.7 Sonnetが25%、DeepSeek R1が39%でした。一方、hintの種類や問題設定ごとの個別結果では、明示率が20%未満となる場合も多くありました。さらに、報酬ハックの実験では、6環境中5環境で明示率が2%未満でした。これは限られたモデル、問題形式、手掛かりの種類、判定条件での結果です。
CoTは望ましくない動きを見つける手掛かりにはなっても、その動きがないことや安全性を、単独で保証するものではありません。
一つの回答だけで判断しない仕組み
評価ケースごとに、最初の回答と説明、説明から取り出した主張、条件を変えた後の回答を記録します。入力と、LLMから観測した結果を分けて記録することがポイントです。
この結果が説明と合っていても、モデル内部の本当の理由が証明されたわけではありません。反対に、合わなければ、少なくともその条件での反例候補になります。入力の意味が壊れていないか、会話履歴が検証側へ混ざっていないか、回答の揺れで説明できないかも別に確認します。
Faithfulnessの評価方法は、何がわかるかで使い分ける
Faithfulnessの評価方法に、どのケースでも使える一つの正解はありません。方法ごとに、調べられる失敗の仮説が違います。下表では、人にとって説明が筋が通っていて納得しやすいかを見るPlausibilityと、入力や説明を変えて回答がどう変わるかを調べる方法を、同じ「説明の質」として混ぜないように整理します。
以下の分類と限界は、CoT介入を扱う[2]、説明形式ごとの検証を扱う[3]、既存のFaithfulness評価を整理した[4]をもとにしています。
| 方法 | 何を見るか | これだけではわからないこと | 主な注意点 | 向いている問い |
|---|---|---|---|---|
| Plausibility(納得しやすさ) | 説明が筋が通っていて、納得しやすいか | 条件を変えたときの回答の変化 | 人や評価用LLM(LLM judge)の基準に左右される | 読者にとって使いやすいか |
| Counterfactual(条件を変えるテスト) | 説明された条件を変えたときの答えの変化 | モデル内部の原因そのもの | 不自然な反実仮想、OOD(学習時とは異なる分布の入力)、複数の特徴が同時に変わること | この条件を変えると、答えも説明どおりに変わるか |
| Feature Attribution(重要な特徴を調べる方法) | 答えに影響したと説明された語や特徴 | その特徴だけが原因か、十分な原因か | 何を重要とするか、どの単位で調べるかを決める | どの手掛かりを調べるか |
| Feature Removal / Redaction(特徴を削除・隠すテスト) | 重要な語を削除・非表示にしたときの答えの変化 | その語だけが原因であること | 文章の文法や意味、入力の傾向が変わること | その特徴が必要そうか |
| CoT Intervention(CoTを変えるテスト) | CoTの文章を変えたときの答えの変化、後付け説明の兆候 | モデル内部の計算を直接見ること | 切断・誤り挿入・言い換えの影響を分けて考える | 説明の文章が答えに影響するか |
| Bias Intervention(入力の偏りを変えるテスト) | 答えを示す手掛かりへの反応と、その手掛かりを説明できているか | 見つけられなかったときのFaithfulness | 人工的な変更、モデル、タスクに左右される | 説明が影響要素を見落とすか |
| Self-Consistency Check(別セッションで確かめる方法) | 別セッションで、説明どおりに回答が変わるか | モデル内部の本当の理由 | 回答の揺れ、履歴の混入、同じ説明を使うことによる偏り | 説明どおりに回答が変わるか |
入力を変えて、説明された特徴の影響を調べる
条件を変えるテスト(counterfactual)は、説明が重要だとした条件を別の条件に変えて、答えが説明どおりに変わるかを確認します。特徴を削除・隠すテスト(redaction)は、重要な語や箇所を削除したり隠したりします。入力の偏りを変えるテスト(bias intervention)は、選択肢の順番や答えを示す手掛かりなど、影響を予測しやすい要素を加えます。どの方法も、成功すれば「試した条件では、説明した部分を変えると回答が説明どおりに変わった」と言えるだけで、原因を完全に証明するものではありません。
説明を変えて、回答生成との対応を調べる
CoTを変えるテスト(CoT intervention)は、CoTを途中で切る、誤りを入れる、言い換える、埋め草に置き換えるなどして、その後の答えがどう変わるかを調べます。別セッションで確かめる方法(self-consistency check)は、説明を作る処理と検証を別セッションで行い、説明どおりに回答が変わるかを確認します。どちらも、説明や説明から作った変更後の入力に対して、回答がどう変わるかを調べる方法であり、モデル内部を直接見る検査ではありません。
評価結果を一つの数値にまとめない
モデル、タスク、説明形式、プロンプト、サンプリング条件を変えると、結果も変わります。Madsenら(ACL Findings 2024)[3]は、IMDb(映画レビューの感情分類データセット)、bAbI(文章を読んで答える推論課題のデータセット)、MCTest(読解問題のデータセット)、RTE(2つの文の関係を判定する課題)と、Llama 2、Falcon、Mistralを対象に、条件を変えるテスト、重要な特徴を調べる方法、特徴を削除・隠すテストを比べました。その結果、どの説明形式が比較的よいかは、モデルやタスクによって異なりました。これは「このモデルはいつもfaithful」という順位ではなく、条件を限った評価結果です。
なお、ArcuschinらのICLR 2025ワークショップ版[5]は、人工的なhintを加えない自然な比較問題でも、質問を反対向きにしたときに同じ答えを返すquestion-pairの食い違いを報告しています。ワークショップ版の数値は、Sonnet 3.7が16.3%、DeepSeek R1が5.3%、ChatGPT-4oが7.0%でした。これは同版のベンチマーク、判定条件、autorater(自動判定)に依存する値です。
このように、単一のfaithfulness_scoreだけを返さず、accuracy、factuality、Plausibility、介入ごとの一致率、失敗例を分けて保存します。LLM judgeを使う場合も、judgeモデル、判定プロンプト、基準、人手監査の有無を記録します。LLM judgeの結果を、絶対に正しい基準として扱わないことが大切です。
LLMアプリで説明を確かめる手順を作る
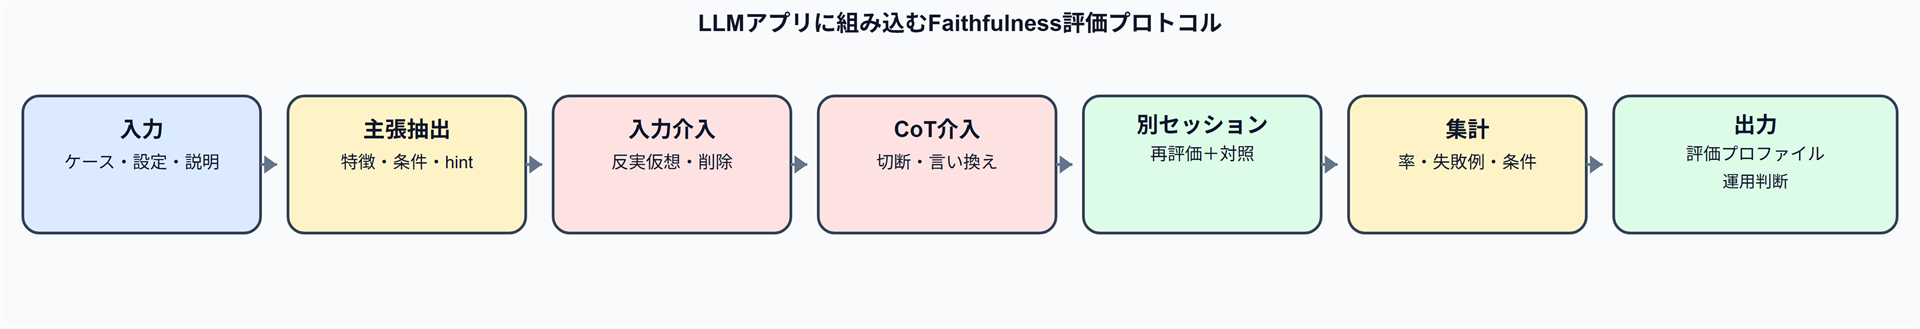
ここまで見てきた方法を、LLMアプリの評価計画に組み込みます。これは、どの分野でも使える標準手順や、普遍的な合格基準というわけではありません。LLMによる説明をそのまま信じてよいか、実際に試して確かめるための進め方の例です。対象は予測ラベル、推薦理由、ツール呼び出し、拒否理由など、一つの用途に絞って始めます。
まず一つの説明形式と一つのタスクで始める
最初に代表的なケースを固定します。対象モデルのスナップショット、システム向けの指示文(system prompt)、先に示す例題(few-shot例)、温度設定(temperature)、候補を絞る設定(top-p)、最大出力、ツール、取得文書、会話履歴も保存します。次に、説明から「重要な特徴」「必要な条件」「推論ステップ」「利用した手掛かり」を取り出します。自由記述の説明を、そのまま採点しないことがポイントです。
入力、説明、比較用の条件を組み合わせる
入力側では、条件を変えるテスト、特徴を削除・隠すテスト、自然な言い換え(paraphrase)、既知の偏りを調べる入力(bias probe)を一つずつ作ります。説明側ではCoTの切断、誤り挿入、言い換え、埋め草置換を試します。変更しない条件、意味を保った条件、独立したサンプルの一致率、温度設定(temperature)や乱数の初期値(seed)の違いも用意します。回答の変化が、条件を変えた影響なのか、単なる回答の揺れや入力の破壊によるものなのかを見分けるためです。
合否だけでなく、用途ごとに結果を報告する
評価では、説明を作る処理と検証を別セッション・別リクエストにします。検証側へ説明や会話履歴を渡すと、説明に引っ張られた再評価になる可能性があるためです。結果は、介入ごとのFaithfulness、回答の正しさ、説明のfactuality、Plausibility、拒否率、信頼区間、問題ごとの失敗例、モデル版、実行条件と一緒に記録します。「このモデルはfaithful」とまとめず、「このタスクのこの説明形式では、指定した条件でこの範囲の一致が見られた」と書きます。
| 観測 | 言えること | 言えないこと | 運用判断の例 |
|---|---|---|---|
| 説明も回答も、変えた条件に合わせて変わる | 試した範囲では、回答が説明どおりに変わっている | 内部理由の完全な証明、正しさ、安全性 | 追加テストと人手確認へ進める |
| 回答は変わるが、説明はその変化に触れない | 説明どおりに回答が変わらない例の候補 | 全体でどのくらい合わないか、意図的な欺瞞かどうか | 自動判断の根拠に使わず、失敗として記録する |
| 重要な特徴を消しても答えが変わらない | その特徴が必要かどうかは確認できない | その特徴を絶対に使っていないこと | 別の特徴、OOD、拒否を追加で調べる |
| Plausibilityだけ高い | 読者には理解しやすい可能性 | LLMがその理由で判断したこと、安全性 | 納得しやすさの指標として扱い、Faithfulnessの合格にはしない |
| テストごとに結果が分かれる | 説明形式・タスク・条件への依存 | 一つの「faithful」判定 | 用途ごとの評価結果として示す |
アンチパターン1:説明の流暢さを合格条件にする。Plausibilityは読み手にとって説明が納得しやすいかを見るもので、入力や説明を変えたときに回答がどう変わるかまでは見ない。
アンチパターン2:一度、特徴を削除・隠すテスト(redaction)をして回答が変わったら、原因を特定できたと断定する。削除によって意味や文法、入力の傾向が変わった可能性や、同時に変わった手掛かりの影響を切り分けられない。
アンチパターン3:Faithfulnessの一つの数値だけで、モデルや用途を比べる。研究結果はモデル、タスク、説明形式、プロンプト、サンプリング条件に依存し、共通の合格基準も決まっていない。
まとめ:説明を信じる前に、答えの変化を確かめる
LLMの説明を評価するときは、回答の正しさ、説明のfactuality、人にとってのPlausibility、説明した部分を変えたときに回答が説明どおりに変わるかというFaithfulnessを分けます。自然で説得力のある説明だけでは、LLMがその理由で回答したとは言えません。Faithfulnessも、モデル内部の理由を直接証明するものではなく、決めた条件で説明どおりに回答が変わったかを見るものです。
実務では、代表的なタスクを一つ、説明形式を一つ選び、説明から主張を取り出します。そのうえで、入力を変えるテストをまず二種類ほど、CoTを変えるテスト、変更しない比較条件、意味を保った比較条件、別セッションでの再評価、人手による確認を小さく組み合わせます。テストの数や強さは、用途とリスクに応じて調整してください。結果は一つの合否ではなく、条件ごとの一致率、通常の正解率、factuality、Plausibility、再現性、失敗例を含めてまとめます。
この結果が安定してから、モデルの版、対象タスク、長い入力、ツール利用へ範囲を広げます。Faithfulnessのテストに通っても、最終回答の正しさ、権限、安全性の確認は省略しません。CoTやSelf-Explanationは調査や監視の手掛かりにはなりますが、それだけを証拠や安全の保証にはしない、という扱いが現実的です。
参考にしたサイト
[1] Language Models Don’t Always Say What They Think:
Unfaithful Explanations in Chain-of-Thought
Prompting

[2] Measuring Faithfulness in Chain-of-Thought Reasoning

[3] Are self-explanations from Large Language Models faithful?

[4] Towards Faithful Model Explanation in NLP: A Survey

[5] Chain-of-Thought Reasoning in the Wild Is Not Always Faithful

[6] Reasoning models don’t always say what they think

投稿日2026年09月04日
カテゴリーTech Blog
タグ LLM評価
