

「LLMの判断だから仕方ない」と言わないための責務分担

鳥
2026.08.14
BTMAIZの鳥と申します。
主に、生成AI関連やAI開発ツールについて発信していきます。
LLMに任せる仕事、コードに任せる仕事
LLMを使ったシステムを設計していると、「この判断もLLMに任せてよいのか」「ここから先はプログラムで固定すべきなのか」と迷う場面があると思います。
一般的に、LLMは自然言語の理解や文脈に応じた要約・分類・候補生成を得意としますが、厳密な数値計算や形式の検証、最新のシステム状態の確認、決められた順序での外部操作は、LLMだけに任せると不安定になりやすい領域です。
LLMの誤りによる結果を誰が検証し、どのように止め、どう復旧するかを考える必要があります。
この記事では、障害対応エージェントの改善過程を通してLLMとプログラムの責務分担について具体的に考えていきます。
最初の設計:LLMに切り分けから復旧まで任せる
まずは、障害対応エージェントを作り始めたばかりの状態を想像してみましょう。
プロンプト(初期version)
アラートとログを確認し、原因を特定してください。
必要に応じて関連サービスを調査し、原因が分かったらサービスを再起動してください。
対応結果を担当者へ報告してください。
この指示は一見すると分かりやすいのですが、LLMに多くの判断と実行を同時に求めています。どのサービスを調べるか、再起動してよいか、失敗したらどうするかまで、モデルの判断に委ねられています。
処理フロー(初期version)
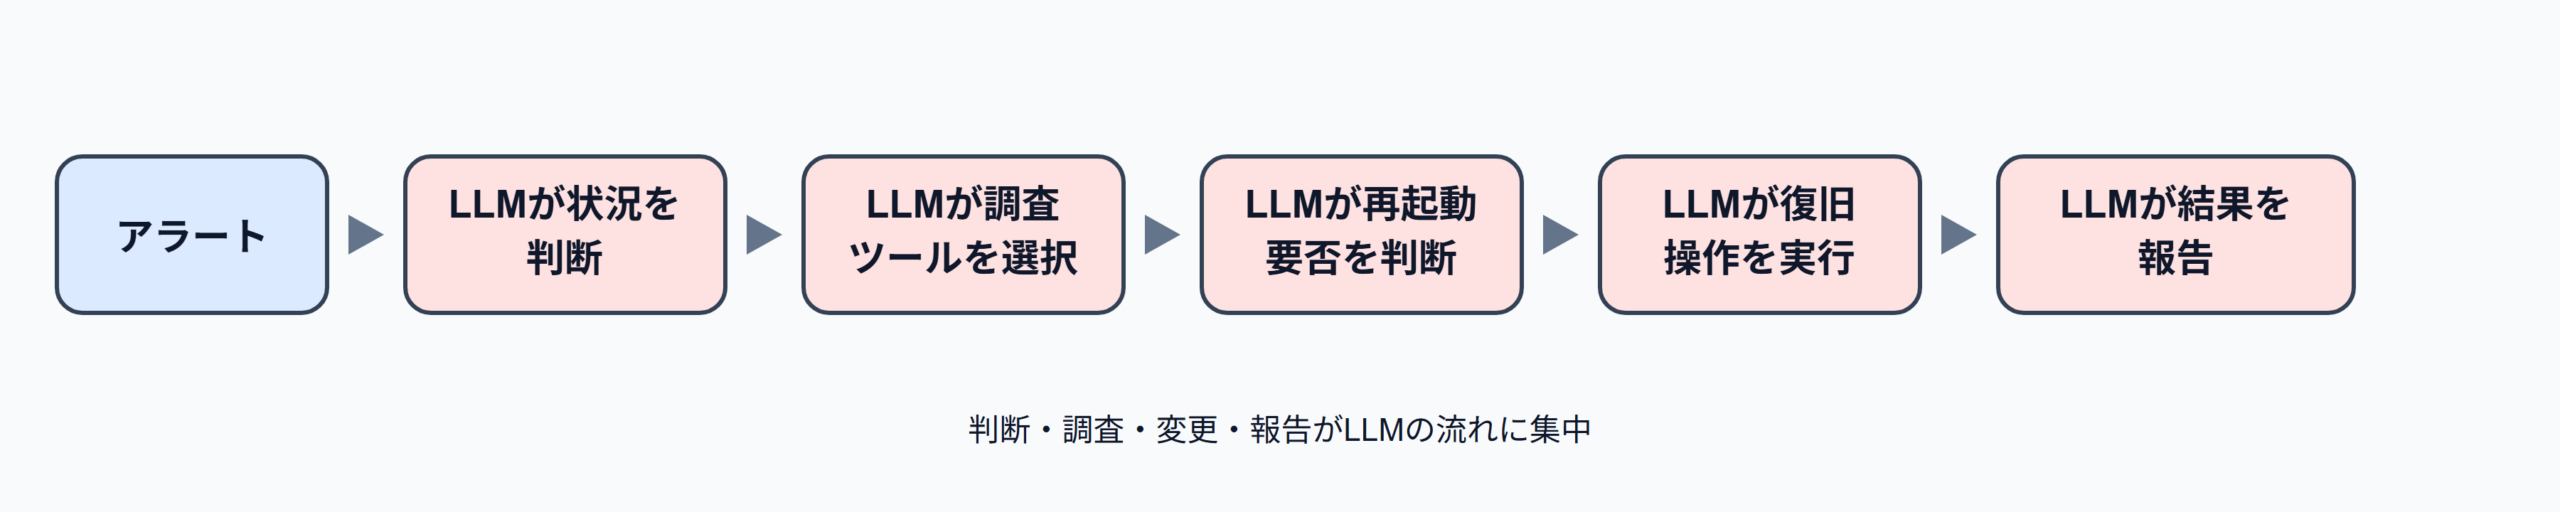
ところが、実際に動かしてみると、プロンプトだけでは決めきれない場面がいくつも見えてきます。初期フローには、たとえば次のような懸念があります。
- 対象を取り違える
ログの読み違いによって、障害とは関係のないサービスを調査したり、再起動したりする可能性があります。 - 環境を取り違える
本番環境と検証環境を正しく区別できなければ、同じ操作でも影響の大きさが大きく変わります。 - 調査の途中で変更まで進んでしまう
ログを確認するだけの安全な操作と、再起動や設定変更のように影響が出る操作の境目が、プロンプトだけでは曖昧です。原因を十分に確認する前に、復旧操作へ進んでしまう可能性があります。 - 処理が止まらない
原因が分からないまま、調査ツールを繰り返し呼んだり、再試行を続けたりする可能性があります。 - 失敗時の出口が曖昧になる
復旧操作に失敗したとき、再試行するのか、いったん停止するのか、人へ引き継ぐのかがプロンプトの解釈に委ねられています。
ここから、設計を一つずつ見直していきます。
修正1:実行責任をコード側へ移す
ここでコード側へ移すのは、単なる「LLMが苦手な処理」の一覧ではありません。もし間違えたときに外部へ影響が出るか、失敗したあとに誰かが復旧しなければならないか。そうした観点から、実行に関わる責任を整理します。
プロンプト(修正version1)
アラートとログを分析し、障害の原因候補と推奨する対応を提示してください。
外部システムの変更やサービスの再起動は実行しないでください。
判断に必要な情報が不足している場合は、不足している情報を列挙してください
LLMには状況の分析と対応案の提示までを依頼し、外部操作は明示的に禁止します。これにより、LLMの提案をコード側で確認してから実行できるようになります。
処理フロー(修正version1)
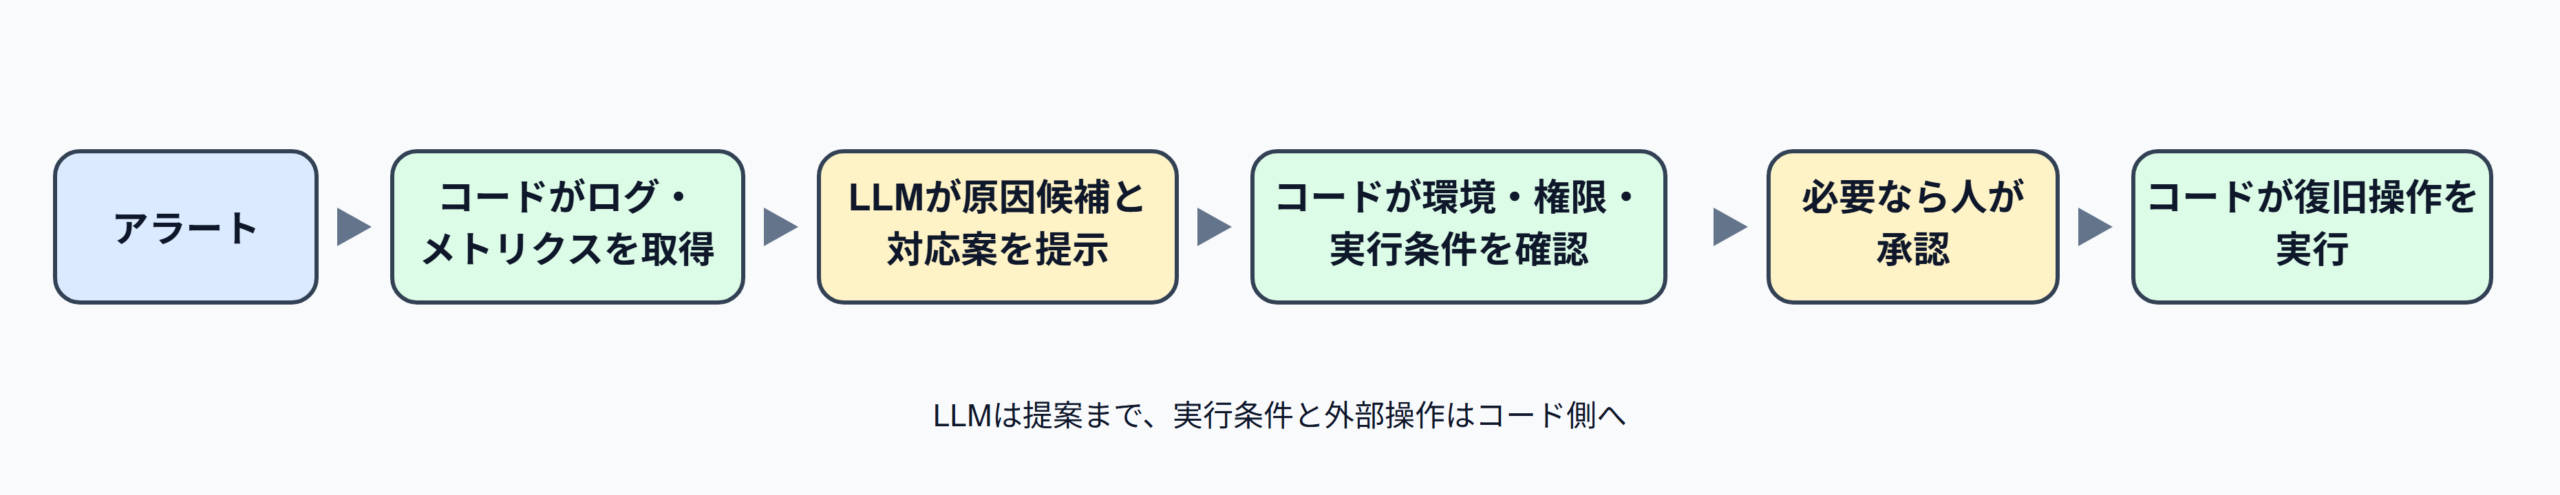
| 処理項目 | 修正1後の担当 | 修正1の意図 |
|---|---|---|
| ログ・メトリクスの取得 | コード | 取得対象や環境を固定し、調査を安全に行うためです。 |
| 状況・原因候補の整理 | LLM | 複数の情報から意味を読み取り、候補を整理する仕事はLLMに任せられるためです。 |
| 対応案の生成 | LLM | 原因候補に応じた対応案を複数出し、人やコードが検討できる形にするためです。 |
| 実行条件の確認 | コード | 対象環境、権限、現在の状態、許可範囲を同じ基準で確認するためです。 |
| 復旧操作 | コード | 再起動や設定変更が、LLMの判断から直接実行されないようにするためです。 |
| 失敗時の扱い | コード | 再試行、停止、承認、オンコールへの引き継ぎをあらかじめ決めるためです。 |
修正2:LLMには意味理解と候補生成を残す
ここまで読むと、「それなら全部コードで決めればよいのでは」と感じるかもしれません。ですが、人の依頼や障害の状況報告は不完全で、意図や背景が埋もれているケースもあります。そこから意味を取り出し、候補を並べ、説明できる形に整える仕事は、LLMが力を発揮しやすい部分です。
大切なのは、LLMに任せる範囲をなくすことではなく、提案と実行を分けることです。修正前は、LLMに原因の特定から復旧操作までを一度に任せていました。修正後は、LLMには状況の解釈と対応案の提示までを任せ、実行してよいかの確認と実際の操作をコード側に移しています。
プロンプト(修正version2)
アラート、ログ、メトリクスを分析し、次のJSON形式で障害対応案を返してください。
{
“observations”: [“確認できた事実”],
“hypotheses”: [“原因候補”],
“recommended_checks”: [“追加で確認すべき項目”],
“recommended_action”: “推奨する対応”,
“confidence”: 0.0,
“missing_information”: [“不足している情報”]
}
JSON以外の文章は返さないでください。
サービスの再起動、設定変更、データ更新などの外部操作は実行しないでください。
事実と推測を分けて記載してください。
修正2では、LLMの提案をさらに整理します。自由な文章で返してもらうのではなく、JSONの項目として事実、推測、追加調査、推奨対応を分けることで、コード側が形式と内容を検証しやすくなります。
ただし、JSON形式をプロンプトで要求するだけで、出力の妥当性を保証できるわけではありません。実装側でスキーマに適合しているかを検証し、形式が崩れていた場合は実行へ進めず、再生成または人への引き継ぎに切り替えます。
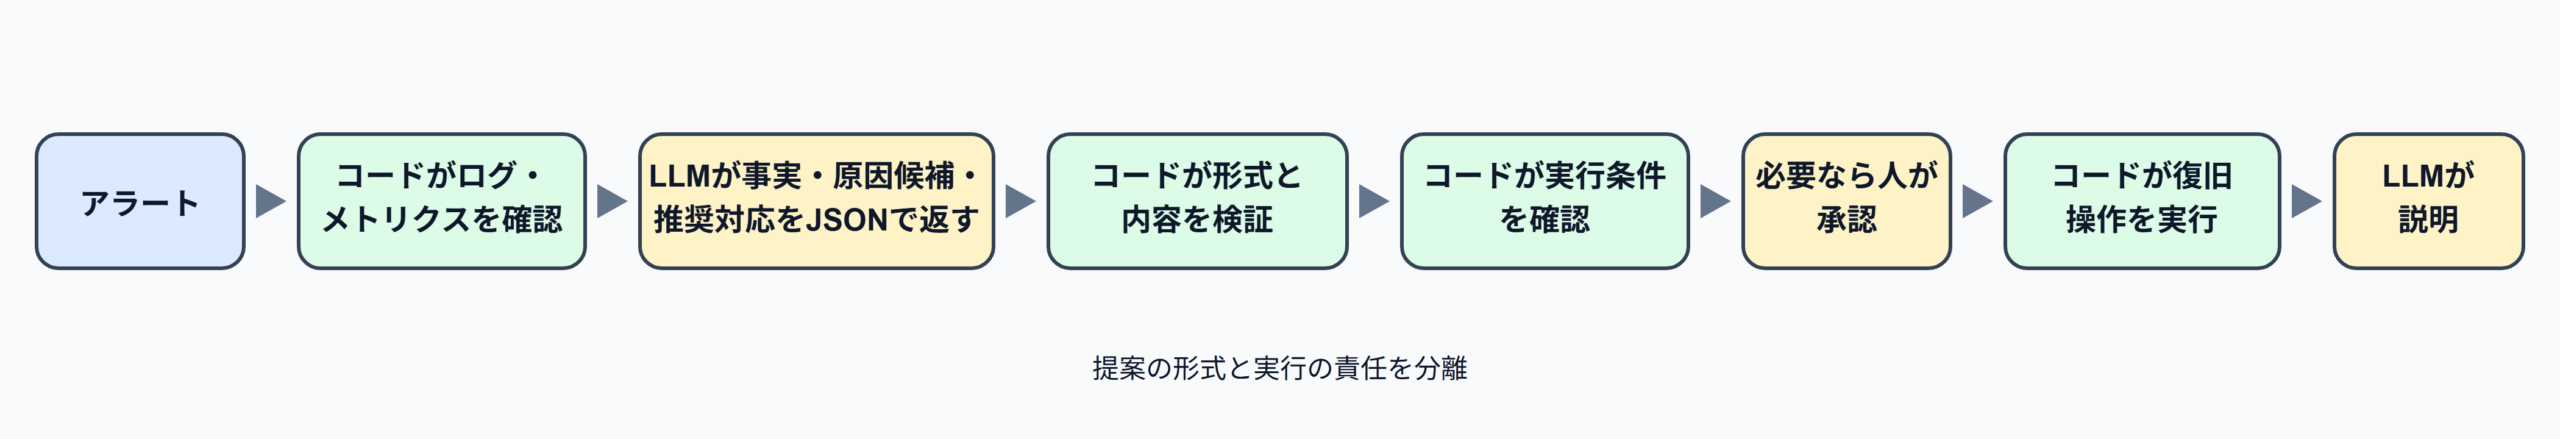
処理フロー(修正version2)
| 観点 | 修正1 | 修正2 | 修正2の意図 |
|---|---|---|---|
| 出力形式 | 自由な文章で状況と対応案を提示 | JSONの項目に分けて出力 | コードが項目ごとに形式を検証しやすくするためです。 |
| 事実と推測 | 同じ文章の中に混在する可能性がある | 確認できた事実と原因候補を別々に出力 | 推測を事実として扱う誤りを減らすためです。 |
| 追加確認 | 必要な調査を文章の中から読み取る | recommended_checksとして明示する | 不足している調査をコード側や担当者が把握しやすくするためです。 |
| 対応案 | 推奨する対応を文章で提示 | recommended_actionとconfidenceを分けて出力 | 対応案と、その判断の確からしさを分けて扱うためです。 |
| 実行前の連携 | コードが自由文を読み取って判断 | JSONの項目を検証してから実行条件を確認 | LLMの文章をそのまま実行判断に使わないためです。 |
| 実行後の説明 | 実行結果をそのまま扱う | コードが結果を確認し、LLMは担当者向けの説明を生成 | 実行の責任と、結果を説明する役割を分けるためです。 |
この流れなら、LLMは「何が起きていそうか」「何を試すべきか」を考え、コードは「実行してよいか」「どの順序で実行するか」「失敗したらどう止めるか」を決めます。LLMが「再起動してよい」と説明していても、コード側の前提条件を満たさなければ実行しない。この境界が、設計全体の安心感につながります。
具体例:CPU使用率急上昇の一次切り分けに当てはめる
最後に、具体的なインシデントを一つ追ってみます。注文APIのCPU使用率が95%を超え、5xxエラーも増加しているというアラートが発生したとします。10分前には新しいバージョンがデプロイされていますが、アクセス数の急増も起きています。
| 段階 | LLMが担当すること | コードが担当すること |
|---|---|---|
| 1. 状況の整理 | CPU、5xxエラー、デプロイ履歴から、起きている事象と原因候補を整理する。 | 対象サービスと本番環境を特定し、ログ・メトリクスの確認を行う。 |
| 2. 追加調査の提案 | 「デプロイ後のエラー増加」と「アクセス数増加」のどちらを確認すべきか提案する。 | 調査対象、環境、許可された操作かを確認し、実行する。 |
| 3. 復旧案の提示 | ロールバックや再起動など、考えられる対応案と確信度を提示する。 | 本番変更の権限、対象バージョン、承認の要否を確認する。 |
| 4. 復旧と報告 | 実行結果を担当者向けに要約し、残る懸念を説明する。 | 承認済みの操作だけを実行し、成功・失敗・引き継ぎを判定する。 |
この例では、LLMが原因候補や対応案を考え、コードが調査の範囲と復旧操作の条件を管理しています。最初からロールバックを実行するのではなく、調査、追加確認、承認、復旧という順に進めることで、LLMの提案を活かしながら本番環境への影響を制御できます。
まとめ
AIエージェントの処理を分けるとき、つい「LLMが苦手かどうか」を基準にしたくなります。ですが、より重要な問いは、「LLMに任せた結果が悪いものだったときに、『LLMの判断なので仕方ない』と済ませられるか」です。
もし「仕方ない」と済ませられない結果につながるなら、その処理をLLMの判断だけに任せてはいけません。意味理解と候補生成はLLMに任せても、外部状態、前提条件、実行順序、失敗時の責任はコード側に置きます。そうすることで、LLMの柔軟さを活かしながら、結果に対する説明責任も持てるようになります。
今のエージェントの設計に迷っているなら、まずはエージェントが起こす外部変化を書き出してみてください。その結果が悪かったときに誰が説明し、どこで止め、どう復旧するのかを考えると、LLMに任せる範囲とコードへ切り出す範囲が自然に見えてきます。
参考にしたサイト


投稿日2026年08月14日
カテゴリーTech Blog
タグ AIエージェント、LLM評価
