

ノーコードで可視化するLLMの推論構成

のいつき
2026-08-21
のいつきと申します。
映画のキャラクターとして見るなら、感情を持ったAIより、無感情で絶妙にずれた会話をするAIの方が好きなエンジニアです。
主にノーコード開発と生成AI関連の発信をしていきますので、よろしくお願いいたします。
ノーコードならではの価値
前回の記事では、ノーコード開発とAI支援開発のハイブリッドが一定の条件下で価値を発揮するという話をしました。(参考記事:ノーコードの限界はAIから何を取り戻すのか)
そこでの結論は、「AIが生成したものを確実にコントロールできるかが重要」というものでした。
処理ステップがノード単位で処理が区切られているからこそ、生成されたものを部品単位で確認できる。AIに触れられる範囲が自然と限定される。この構造がバイブコーディングのリスクを抑えられるという話です。
今回はAI支援開発からは離れ、ノーコード開発それ自体をピックアップし、「ノーコードでなければ生み出せない価値」を探ろうと思います。
LLMを切り分ける
ノーコード開発のわかりきった魅力としてまず思い浮かぶのは、処理フローの可視化です。再三申し上げてきた通り、ノードで様々な処理を実行し、結果を次のノードに渡したり、条件分岐したり、並列で処理を進めたりできます。これは非エンジニアだけでなくエンジニアにとってもありがたい性質でしょう。いくらコードに慣れていても、複雑な処理フローをコードから直にイメージ・把握するのはそれなりにたいへんです。
そしてそこからもう少し踏み込んでみると、ノーコード開発ではノードごとにLLMの推論が分かれるという特性に気が付きます。
文言としては地味で凄みに欠けますが、実はこの当たり前のような挙動をAIに素直にやらせるのは、意外とお金がかかったり手間がかかったりするのです。
例えばアプリのClaudeやChatGPTなどを使う時ですが、推論や生成のルールをシステムプロンプトやパーソナライズ設定で細かく指示するには限界があります。
文章構成、思考過程、論理展開、禁止事項、自己検証。こうした指示をいくら盛り込んでも、書かれた手順どおりに毎回実行される保証はありません。「まず構成を考えてから文章を整える」「検索して得た情報の内、必要なものだけ引用する」「書いた文章を見返す」。こうした段階的な挙動を常に踏んでくれるとは限らず、チャットでは会話が膨らむほどこの傾向が強まります。
これを解決しようとして、具体例や詳細なパターン分けなどでシステムプロンプトを充実させても、情報量が増え過ぎて却って精度が落ちることがあります。加えて、入力トークン量が増え、API利用料の増加や使用上限への到達も招くでしょう。
かといって高性能モデルを使ったり推論時の思考の反復回数を増やしたりすれば、精度は上がるかもしれませんが、これでもトークン当たりの料金や入出力トークン量が増えてやはりコスト増に繋がります。
つまり、一度のLLM推論だけで精度を担保するのは難しいのです。
一方でDifyのようなノーコード開発では、複数のLLMノードにそれぞれ役割を割り当て、処理を切り分けるという対策を採ることできます。
各ノードは推論や生成の処理、つまり役割が混ざらず、ユーザーが入力したプロンプトや前段から受け取った生成結果に対して与えられた機能だけを果たします。
一つのノードが一つの仕事に専念することで、挙動が安定するのです。
そして開発者もまた、推論過程をステップごとに把握し、必要な箇所だけをピンポイントで調整して性能や挙動をコントロールしやすくなる訳です。
Claude Code Skills・Subagentsとの違い
「複数のLLMを連携させる」「LLMに役割ごとの挙動を取らせる」「モデルを切り替えながら推論する」という発想自体は、実はDify以外にも存在します。例えばClaude CodeにはSkillsとSubagentsという仕組みがあります。
Skills:手順書をパッケージ化する
Skillsは、特定のタスクの指示書・スクリプト・参照資料を一つのフォルダにまとめたものです。
中心となるのはSKILL.mdというファイルで、そこに「何をするスキルか」「いつ使うか」を書いておきます。
特徴的なのは、呼び出し方が原則モデル任せである点です。Claudeがタスク内容とスキルの説明文を照らし合わせ、関連すると判断したときに自動で発動します。
もう一つの肝が段階的開示(progressive disclosure)という仕組みです。
Claudeは最初に各スキルの名前と説明文だけを読み込み、関連すると判断した段階で本文を読み、必要になって初めて同梱スクリプトや参照資料を開きます。
これにより、大量のスキルを用意しても、使わないものはコンテキストをほとんど消費しません。
Subagents:独立した文脈を持つ別働隊
Subagentsは、メインの会話とは別のコンテキストウィンドウでClaudeを起動し、独立したタスクを実行させる機能です。
それぞれのSubagentには専用のシステムプロンプトと、使わせるツール、使用するモデルもSubagentごとに指定できます。重い調査はOpus、軽い定型処理はHaiku、といった使い分けが可能なのです。
このSubagentsの最大の利点は、文脈が分離されることです。調査や検証といった重い作業を別の文脈に切り出せるので、メイン会話が余計な情報で膨らむのを防げます。
呼び出し方は、Claudeが自動で振り分ける場合と、ユーザーが名前を指定する場合の両方があります。
また、この2つは排他的なものではなく、組み合わせて入れ子にできます。
SubagentもClaudeの実体である以上、その内部でSkillsを発動できます。つまり「Subagentの中でSkillを使う」構成にできます。
逆に、Skillの手順書の中に「ここでSubagentを起動して調べさせる」と書いておくこともできます。こちらは「Skillの中からSubagentを呼ぶ」構成です。
役割をまとめた手順書(Skill)と、独立した実行部隊(Subagent)を、目的に応じて多層に、柔軟に組み上げられる訳です。
これらの特性の違いから、実装時の安定性やコスト予測可能性に差が生じます。
とはいえ、どちらも万能ではありません。それぞれ以下のような欠点もあります。
- 発動は確実でない:説明文の書き方が曖昧だと、使ってほしい場面でSkillsが発動しなかったり、逆に不要な場面で暴発したりします
- 実行タイミングを握りにくい:Claudeの自動発火に任せていると、Skillsがいつ・どの順序で発動するかをユーザーが厳密に制御しづらく、処理フローを固定したい用途には向きません
- メイン会話の文脈を消費する:Skillsの段階的開示が防ぐのは未使用スキルのコスト分だけで、発動したスキル自体の本文・実行結果はメイン会話にそのまま積み上がります。つまりコスト増に繋がります
- 起動時コスト:Subagentを新規に呼び出す際はシステムプロンプトや必要な文脈を都度読み込み直すため、状態を継続する設定をしない場合、再読み込みの度に追加のトークンが消費されます。つまりこれもコスト増加の要因となります
- 状態が引き継がれない:Subagentsの呼び出し間では記憶が残らないので、渡すべき情報は都度こちらで用意して渡す必要があります
- 受け渡しのコントロールに限界がある:Subagentsで親から子へ何を渡すかは指示ベースの制御になり、Difyのように「この出力のこの部分だけ」と機械的に絞り込む訳ではありません
それに対しDifyは、ノードごとにモデルや拡張思考、トークン上限などを設定した上で、システムプロンプトも必要最低限の内容を個別に設定でき、後段に渡す情報も最小限に留められます。
結果として、無駄なトークンを送らずに済み、処理の流れも一目で追えます。
Claude CodeのSkills/Subagentsが「柔軟に追加できる外部の手」だとすれば、Difyのノード構成は「最初から全体の流れを設計して最適化する」アプローチだと言えます。
ノード分割による推論構成3例
それでは、実際にDifyで組める推論構成の例を3つ紹介します。
今回は具体的な精度やコストの実測までは踏み込まず、「こういう構成を可視化して組める」という紹介に留めます。
1. 直列カスケード構成(Prompt Chaining)
これは、処理をシンプルに多段に分け、上流から下流へ素直に受け渡す構成です。
典型的な構成は次のようになります。
- 知識検索(RAG):ユーザー入力を元に、関連する情報をナレッジベースから取得
- 骨子作成(Claude Opus系やFable系など、思考の反復に強い高性能モデル):ユーザー入力とナレッジ情報を元に、アウトラインと論理構成を設計
- 本文生成(Claude Sonnet系のような汎用的な処理をバランス良くこなす中間モデル):骨子とナレッジ情報に沿った本文の執筆
- 検証(Claude Haiku系のような低コスト・低レイテンシに振った軽量モデル):骨子と本文の照合、トーン・NG表現のチェック

段の切り方は目的に応じて自由であり、「骨子→本文」という分担は一例に過ぎません。
他にも、ただ漫然と高性能モデルを使うのではなく、LLM自身に反証させながら結論の精度を高めていく以下のようなフローも考えられます。
- 問題提起(中間モデル)
- 仮の結論を提示(中間モデル)
- 仮の結論に対する反証を推論(高性能モデル)
- 反証に対してさらに反論を試みる(高性能モデル)
- 最終的な結論(中間モデル)
重要なのは、重い思考や機械的な検証ででモデルの使い分けによるコスト最適化、役割に徹した推論や生成による精度・純度の向上を狙えることです。
例えば骨子作成に高性能モデル、本文生成に中間モデル、検証に軽量モデルを割り当てれば、高性能モデルで全段を処理するより大幅にコストを抑えられます。
反証や反論をそれぞれ異なるノードで思考を混在させることなく推論させることで、客観的な分析や対案提示もできるでしょう。
2. ルーティング構成(Routing)
これは入力の性質に応じて経路を選ぶ構造です。
例えば次のような4つの経路に分岐させることができます。
- 社内ナレッジで答えられる質問 → 知識検索 → 中間モデルが回答
- 社内ナレッジに該当がない一般的な質問 → 検索を通さず中間モデルが推論のみで回答
- 複雑な質問 → 知識検索 → 高性能モデルで推論・生成
- 緊急の問い合わせなど → 知識検索 → 確実性を優先したプロンプト(推測を禁止)
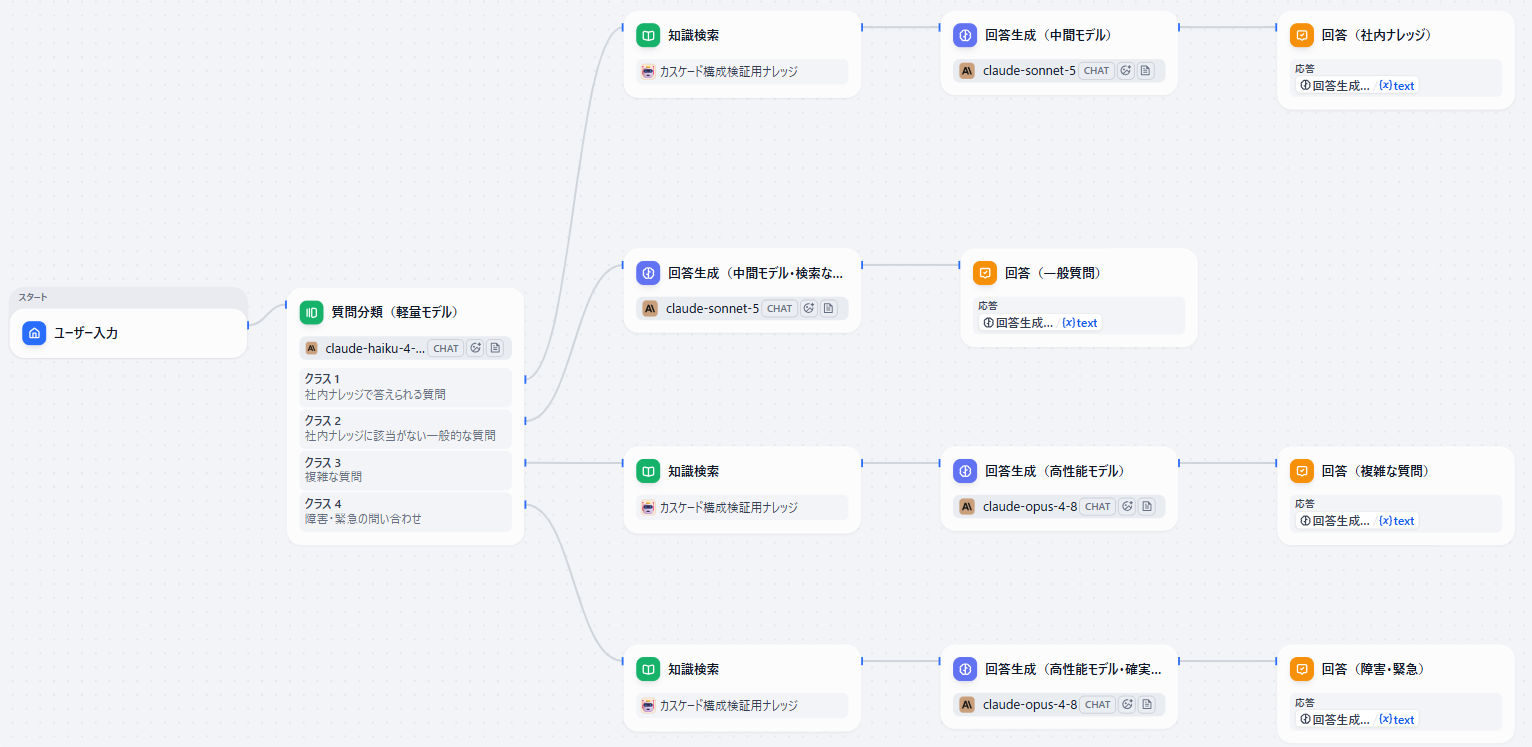
最初に質問分類ノード(軽量モデル)で4経路のどれかに振り分け、それぞれ最適な処理を走らせます。
ルーティングが効くのは、問い合わせの性質が明確に分類でき、経路ごとに最適な処理が異なる場合です。
例えば社内ヘルプデスクやカスタマーサポートの一次対応では、大半が単純な質問で、一部だけ複雑な質問が混ざります。
単純な質問に重いモデルを使うのは無駄なので、軽いモデルで高速に処理し、複雑な質問だけ重いモデルに回す、という設計が現実的です。
ただし分岐自体が曖昧だと、誤判定によって誤った経路に振られ、応答の質が大きく落ちるリスクがあります。
3. アンサンブル型並列構成(Parallelization)
最後の1つは、複数の独立した生成を並列に走らせ、複数の観点から評価・採用する構造です。
原義はアンサンブル学習というもので、複数のベース学習器に多様性を持たせてAIの学習精度を向上させるものです。上記の命名はそれに類似するノード構成ということでの便宜的なものであり、アンサンブル学習と同義ではありません。
この構成で押さえておきたいのは、生成側と評価側で、多様性の持たせ方が違うという点です。
生成側に役割や方針の違いを持ち込むと、比較対象の性質そのものが変わってしまい、「独立した複数の回答」ではなく「異なる目的に基づいた完全な別物」になります。これでは評価の土台が崩れます。生成は同一モデル・同一プロンプトのまま、温度(temperature)を上げて複数回走らせ、ランダム性のある回答を生成させるのが原則です。
一方、評価側は逆です。単一の評価者が1回で採点すると、その評価者固有の偏り(例えば長さを過剰に評価するなど)がそのまま結果に乗ります。評価者ごとに異なる観点を持たせたほうが、互いの偏りを打ち消し合い、原義の異質なアンサンブルとして機能します。同時に、採点・評価という決定論的なタスクではあるのでモデルは軽量でも精度を担保しやすいでしょう。
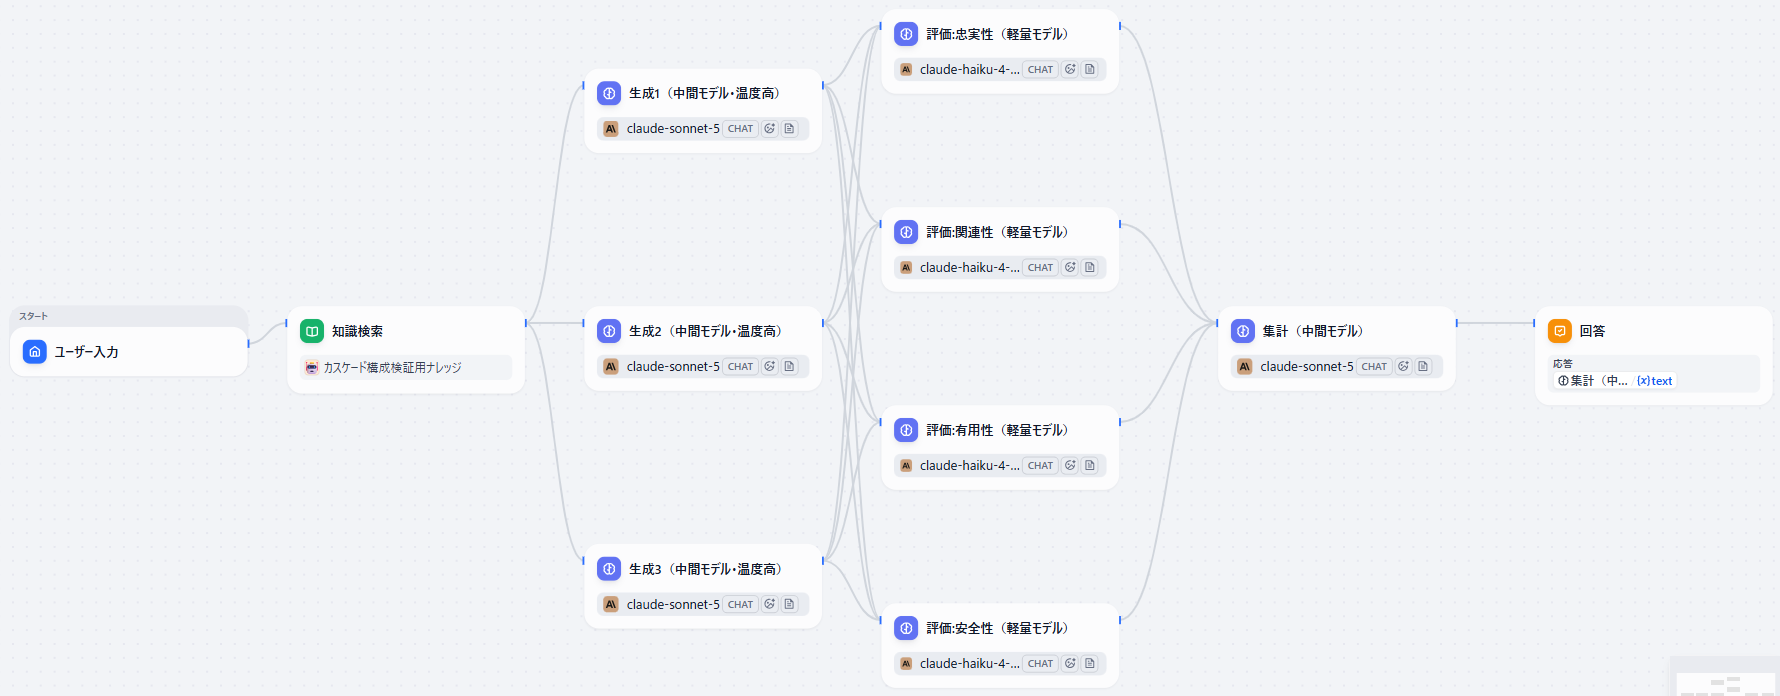
実装例の流れとしては、知識検索後、同一モデル(中間モデル)・同一プロンプトのまま温度を上げ、3系統の回答案を並列に生成します。
評価ノードの観点はタスクに応じて選びます。RAG回答の評価でよく使われる観点には、次のようなものなどがあります。
- 忠実性:ナレッジベースの内容に根拠づけられているか(捏造していないか)
- 関連性:ユーザーの質問に的確に答えているか(論点がズレていないか)
- 有用性:ユーザーが実際に抱える課題の解決に役立つか
- 安全性:社内規約やコンプライアンスに反する助言を含んでいないか
もちろんプロジェクトによって様々な評価軸を設定でき、その中から対象タスクで見落とすと困る観点を選び、その数だけ評価ノードを立てます。3つの回答案を、そして評価ノード群に通してスコアリングします。
複数の回答案×複数の評価観点で採点した結果を、最後に集計ノードで合算し、最も評価の高い回答案を採用します。単一ノードで生成した場合に比べ、満たすべき基準を高水準に満たした応答を得やすいのが特徴です。
アンサンブル型並列構造が効くのは、唯一の正解がなく、複数の案・複数の視点を突き合わせることで結果の質が上がるタスクや、見落としのコストが高く、多角的なチェックに価値がある検証・監査系タスクです。
逆に、唯一の正解が明確に存在する事実照会や、レイテンシがシビアなリアルタイム応答には向きません。並列実行と集約の分だけ時間がかかるからです。
構成の可視化こそが説得力
今回は3つの構成を紹介しましたが、他にも様々なアプローチがあるでしょう。そして何より重要なのは、「どれが優れているか」ではありません。
これらの様々な構成を視覚的に把握し、コストや精度に合わせて柔軟に合成できることこそが最大の強みです。
もしこれをコードで実装するなら、様々な手順や組み合わせ、パラメータを試して修正する度に多大な労力がかかるでしょう。
LangChainやLangGraphを使えば、理屈上は同じ構造を組めます。しかし現実には、モデルごとのAPIクライアント管理、並列実行の制御、入出力のバリデーション、ログとトレース、デプロイ環境の構築といった周辺作業が都度発生します。
どれも技術的には可能ですが、「色々試してみる」「どれを採用するかまだわからない」段階で手間がかかり過ぎるのは好ましくありません。
しかしDifyのようなノーコード開発であれば、ノードの配置によって視覚的に構成を把握し、直感的に組み替えることが可能です。もちろん、ノード内のシステムプロンプトやパラメータの変更履歴を残す手間はコーディングの時と同様に残りますが、劇的に軽いと言えます。
試行錯誤のコストが圧倒的に低く、目的に応じた最適な構造を柔軟に追求できることは業務の効率化や品質向上に大きく貢献するでしょう。
「コードで書けばもっと柔軟に作れるのでは」という意見もあると思います。それは正しいです。
ただし、その柔軟性が必要になるのは「Difyの想定を超えた要件が出てきた時」です。大半のユースケースでは、Difyの提供する構造で十分だと考えられます。
そして非エンジニアが構造設計に参加できるかどうかという観点でも、Difyのような可視化された環境の方が圧倒的に有利でしょう。
まとめ
今回の記事では、Difyを題材に「ノーコードが可視化するLLM推論の様々な構成」を紹介しました。
直列カスケード構成、ルーティング構成、アンサンブル型並列構成。それぞれ異なりますが、どれも画面上でノードを繋ぐだけで組み立てられます。
重要なのは、利用者が都度調整しながら、コスト・精度・用途に最適化した構成を組み上げられる点です。
コードで同じことをやろうとすると、APIクライアント管理、並列実行、ログ、デプロイなど、構造設計以外の周辺作業に時間を取られます。
Difyはその周辺作業をすべて吸収し、構成設計そのものに集中させてくれます。そして構成が可視化されているから、非エンジニアでも「このノードで何が起きているか」を把握できます。
これが、ノーコードでなければ生み出せない価値の一つです。
次回では、直列カスケード構成の精度やコストを実際に測定し、単発のLLM呼び出しと比較する予定です。
引き続きお付き合いください。
参考リンク


投稿日2026年08月20日
カテゴリーTech Blog
タグ ノーコード
