BTMAIZ のえだまめです。
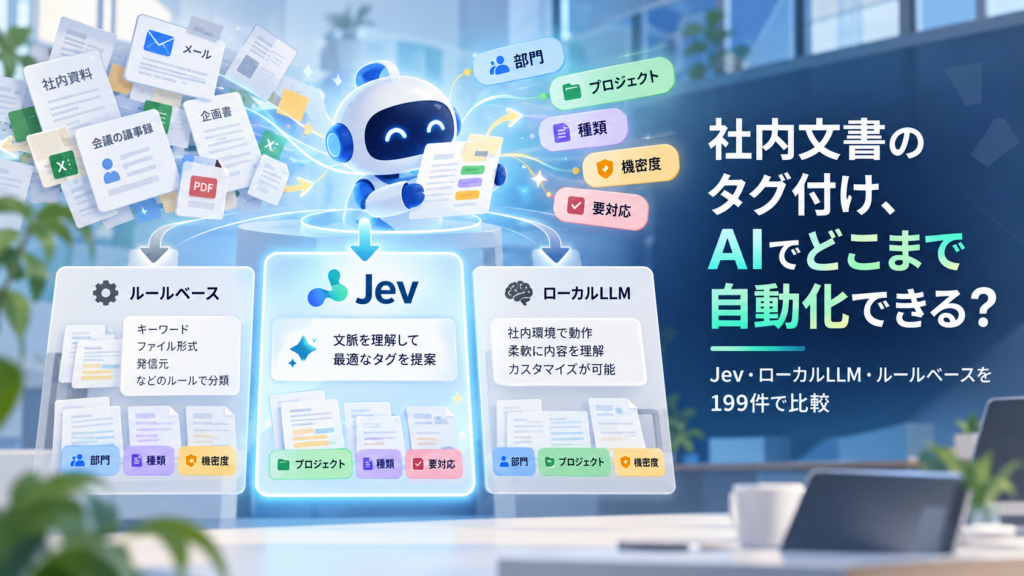
社内にたまった文書・メール・議事録に、「どの部署の話か」「機密かどうか」といったタグ(文書に付ける目印のラベル)を付けておくと、探す・守る・拾い漏らさないが楽になります。ただ、人手で付け続けるのは大変です。そこで今回は、タグ付けをどこまで自動でできるかを、3つの方法で比べました。新しいAI「Jev」(文章は書かず、「選択肢のうちどれか」だけを選ぶAIです)、手元のPCで動かす無料のローカルLLM、ルールベース(AIを使わず、「この言葉が出てきたらこのタグ」と人があらかじめ決めた規則で振り分ける方法)です。実際の社内文書は使えないので、AIで作った架空の文書(合成データ)で試しています。
要点
AIで作った架空の文書(合成データ)199件で、3つの方式によるタグ付けを比べました。結論から言うと、「Jevが少し正確で、速く、回答の一致率も高い」という程度の差で、劇的な差ではありませんでした。
- 5つのタグの平均正答率(5つのタグそれぞれの正答率の平均):ルール85.6%、ローカルLLM87.4%、Jev90.8%。差は数ポイントです。
- Jevは速く、安く、安定していた:1件あたり約0.4秒、1,000件で約0.2ドル。同じ入力を3回流しても、部門とプロジェクトの答えは199件すべて同じでした。
- 人が見るタグは、確信度で絞れる:Jevは答えと一緒に「自信の度合い」(確信度、0〜1)を返します。確信度0.9以上の部門は99%正解、それ未満は59%まで下がりました。確信度0.9未満だったタグ判定は約2割で、人が確認する対象を絞る目安になりそうです。
- 機密度だけはルールが強かった:今回のデータには「社外秘」などの目印があったため、ルールが約99%でした(正解が「公開」とされた15件を除いた値。全件では91%で、Jevの82%より上です)。
- ローカルLLMは無料で、要対応は得意:手元のPCの中で動かし、API費用は0円。ただし1件約3.5秒かかり、確信度は当てにしにくい結果でした。
これは合成データ199件の小規模な検証です。結論は「この規模・この条件では」と読んでください。
何を確かめたのか
社内には、文書・メール・議事録が散らばっています。たとえば、共有フォルダに数千件のファイルがあり、「営業部の、あの案件の、機密の議事録」を探したいとします。そこに次の5つのタグが付いていれば、「営業部の、あの案件の、機密の議事録」のように絞れて、探す・守る・対応漏れを防ぐが楽になります。
- 部門:どの部署の話か
- プロジェクト:どの案件の話か
- 種類:提案・契約・報告などの文書の種類
- 機密度:公開・社内・機密
- 要対応:誰かが何かをする必要があるか
問題は、これを人手で付け続けるのは大変だということです。そこで「タグ付けを、どこまで安く自動化できるか」を確かめました。
散らばった情報に、5つのタグを自動で付ける
比べた3つの方式
| 方式 |
たとえると |
特徴 |
| ルールベース |
AIは使わず、「社外秘」という言葉があれば機密、のように、人が決めた規則でタグを付ける係 |
速くて無料。目印の言葉がある時は強いが、言い回しが変わったり、目印がなかったりすると外れる |
| Jev |
文章は書かず、選択肢のうちどれかを確信度つきで答える専門家 |
前回の記事で使った型付きの判断モデル。速く、確信度が出る |
| ローカルLLM |
手元のPCの中で動く、文章を理解できるAI(Ollama + qwen3.5) |
API料金は0円。ただし手元のPCの性能に依存し、1件に数秒かかる |
3つの方式の違い
Jevは、TypeSafe AI社が2026年9月に早期アクセスを開始した、文章を書かずに「選択肢のうちどれか」を選ぶ型付きのモデルです。前回の記事では、社内文書を探す仕組みの「選ぶ」役として使いました。今回は、タグを選ぶ役として使っています。
ローカルLLMは、インターネットのサービスに頼らず、手元のPCの中で動かすAIです。無料のOllamaというソフトと、qwen3.5というモデルを使いました。API費用はかからず、データを社外に出さずに動かせるのが利点です。手元のPCの構成は、GPUがRTX 5080 Laptop(VRAM 16GB)、メモリが32GBです。
どう確かめたのか
- 架空の会社の文書・メール・議事録を生成した合成データを使いました(実際の社内文書は使っていません)。
- 評価用の199件で、5つのタグの「正解」を先に決めておき、3つの方式が何件当てるかを数えました。しきい値などを決めるための開発用101件は、別に取り分けています。
- 分析の計画は、分類を始める前に固定してから採点しました。
- Jevは同じ入力を3回流して、答えがぶれないかも見ています。
- さらに、Jevが「自信がない」ときだけローカルLLMに回す「カスケード」も試しました。
結果:Jevは少し正確で、速く、安定していた
5つのタグの平均正答率(評価用199件)は、ルールベース85.6%、ローカルLLM87.4%、Jev90.8%でした。Jevが一番高いものの、差は数ポイントです。「劇的に勝つ」ではなく、「少し正確で、速く、回答の一致率も高い」というのが正直な印象です。
- 速さ:1件あたりの中央値は、Jevが0.39秒、ローカルLLMが3.49秒でした。
- 費用:Jevは1,000件で約0.2ドル、ローカルLLMは0円(電気代のみ)。仕分け編の全段階(予備検証から長文の確認まで、呼び出し1,123回)のAPI費用の合計は、約0.24ドルでした。本番の仕分け300件は、1回分で約0.06ドルです。
- 安定性:Jevは3回流しても、部門とプロジェクトの答えは199件すべて同じでした。
タグごとの正答率(ルール/Jev/ローカルLLM)
人の目に回す目安:確信度
Jevは答えと一緒に、「どれくらい自信があるか」(確信度)を返します。これが、実用上いちばん役に立ちました。
- 確信度0.9以上の部門は、172件中171件(99%)が正解でした。
- 確信度0.9未満になると、27件中16件(59%)まで下がりました。
つまり、確信度を目安に人が確認するタグを絞れそうです。評価用では、199件の文書に対する5種類のタグ判定995件のうち、202件(約2割)が確信度0.9未満でした。ただし、高い確信度でもタグによって正答率は異なるため、自動採用には注意が必要です。なお、Jevが自信のないタグだけをローカルLLMに回す方法も試しましたが、Jev単独(90.8%)を超えませんでした(90.5%、詳しくは付録)。ローカルLLMの確信度は較正されておらず、同じ使い方はやや不安です。
確信度で、人が見るタグを絞る
具体例:1通のメールを仕分けると
評価用の合成データで、1通のメールがどう仕分けられたかを見てみます。法務部からの「【要対応】個人情報保護規程関連の契約条項見直しに関する件」というメールです。本文は、個人情報の扱いに関する契約書の条文(収集目的、第三者提供、苦情処理窓口)を見直し、明日の15時までに修正案を出してほしい、という依頼でした。
| タグ |
正解 |
ルール |
Jev(確信度) |
ローカルLLM |
| 部門 |
法務 |
法務 |
法務(1.00) |
法務 |
| プロジェクト |
P35(個人情報保護) |
該当なし |
P35(0.83) |
該当なし |
| 種類 |
契約 |
契約 |
連絡(0.72) |
提案 |
| 機密度 |
社内 |
機密 |
社内(0.86) |
社内 |
| 要対応 |
あり |
あり |
あり(0.99) |
あり |
- ルールは、本文に「機密情報」という言葉が出てくるため、キーワードに反応して「機密」としたとみられます(推測です)。本文には案件名が書かれておらず、プロジェクトも見つけられませんでした。
- ローカルLLMも、プロジェクトを見つけられず、種類は「提案」としました。
- Jevは、プロジェクトと機密度を当てました。種類は「連絡」で、正解ラベルの「契約」とは違います。ただし、確信度は0.72と低めでした。
面白いのは、この「契約」というラベルの方が怪しいことです。メールは契約書そのものではなく、条項の見直しの依頼です。別のAIによる確認でも、「提案または連絡」のほうが妥当という指摘でした。つまりJevの「連絡」は、必ずしも間違いとは言えません。そして、Jevは確信度が0.9未満のタグ(プロジェクト・種類・機密度)を、自分から「自信がない」と示していました。運用では、この3つのタグが「人が見る」対象になります。
ルールが強かった所:機密度
意外だったのは機密度です。ここだけはルールベースがいちばん良く、約99%でした。Jevは約89%、ローカルLLMは約84%です。これは、正解ラベルが「公開」とされた15件(ラベルの付け方に問題があったため、別に扱いました)を除いた値で、全件では、ルール91%、Jev82%、ローカルLLM78%でした。
理由は単純で、今回のデータには「社外秘」「関係者限り」のような目印が文書に書かれていたからです。目印があれば、ルールは素直に当たります。実際の社内文書に同じ目印があるとは限らないので、「ルールはいつも強い」ではなく「目印が揃っていれば強い」と読むのが安全です。
また、JevとローカルLLMの機密度の間違いは、ほぼ「社内」を「機密」と判定する側に倒れました(詳細は付録)。機密を見逃した件は、どの方式も0件でした。
導入を考えるときの目安
この検証の範囲で言えることを、目安として書きます。
- 一次のタグ付けはJev:速く安く、確信度が出るので、人に回す目安になります。
- 機密度は、目印のルールを併用:文書に目印がある運用なら、ルールを足すと強くなります。
- 確信度が低いタグは人が見る:「自信がない時だけLLM」を試しましたが、今回は伸びませんでした(付録)。
- 長文は事前に分けて渡す:Jevには入力の上限があり、本文が約3万2千字以上の2件(メール1通と議事録1件)は、上限を超えてエラーになりました。
- まず合成データで試す:本物の社内文書に入れる前に、同じ手順で小さく確かめられます。
この検証の限界
- 文書はすべて合成データです。実際の社内文書では、結果が変わる可能性があります。
- 「正解」は、文書を作ったときのラベルを、別のAI(Claude)が独立に確認したものです。人が全件を見直したわけではありません。
- テスト文書の本文を生成したのも、ローカルLLMと同じqwen3.5です。言い回しの癖を共有しているため、ローカルLLMに有利に働く可能性があります。
- 正解が「公開」とされた15件の多くは、本文が公開を支持していませんでした(生成の失敗)。機密度の集計では、別に扱っています。
- 件数が199件なので、1〜2ポイントの差は誤差の範囲です。
まとめと次回予告
合成データ199件で、タグ付けを3つの方式で比べました。Jevは平均90.8%で最も高く、速く、安く、安定していましたが、差は数ポイントです。確信度で人が見るタグを絞れること、機密度は目印があればルールが強いことが、実務に近いわかったことでした。ローカルLLMは、無料で手元のPCで動かせる点が魅力で、要対応の判定は得意でした。
次回の「Copilot編」では、このタグをSharePointの列に書き戻し、Microsoft 365 Copilot(Work IQ)の答えがどう変わるかを測ります。
付録:技術者向けの詳細
評価設計
- データ:合成の文書・メール・議事録。評価用199件、開発用101件(開発用はカスケードのしきい値を決めるためだけに使用)。
- 5軸:部門・プロジェクト・種類・機密度・要対応。
- 方式:ルールベース / Jev(run0〜run2の3回) / ローカルLLM(Ollama qwen3.5:latest、9.7B、Q4_K_M、思考モードoff、num_ctx 8192、num_predict 4096) / カスケード(Jev run0 → 確信度がしきい値未満の軸だけローカルLLM)。
- 精度は、正答率とWilsonの95%信頼区間で報告しました。分析計画は、分類を始める前に固定しています。
データの形:入力と出力
仕分けで扱ったデータの形を、1通のメール(前半の具体例と同じ mail-0011)で示します。キー名は、読みやすいように簡略化しています。
1. 入力:文書1件
{
  "id": "mail-0011",
  "type": "email",            // document / email / minutes
  "title": "【要対応】個人情報保護規程関連の契約条項見直しに関する件",
  "body": "各位\n\nお疲れ様です。法務部の…と申します。…(以下、条文の見直し依頼が続く)"
}
2. 判定する5つのタグと、選択肢
| タグ(キー名) |
選択肢 |
| 部門(department) |
営業 / 開発 / 法務 / 人事 / 経理 / 経営企画 など |
| プロジェクト(project) |
案件コード(P01〜)+該当なし。約40の案件から選ぶ(予備検証では41択) |
| 種類(doc_kind) |
提案 / 契約 / 報告 / 連絡 / 仕様 / 議事 |
| 機密度(sensitivity) |
公開 / 社内 / 機密 |
| 要対応(needs_action) |
あり / なし |
Jevには、1件につき1回、本文と「5つのタグそれぞれの質問と選択肢(定義の説明つき)」を渡しました。ローカルLLMには、選択肢を縛ったJSONで、5つのタグを1回で答えさせています。
3. 出力:Jevの答え(タグごとに、値と確信度)
{
  "id": "mail-0011",
  "department":   { "value": "法務",  "confidence": 1.00 },
  "project":      { "value": "P35",   "confidence": 0.83 },
  "doc_kind":     { "value": "連絡",  "confidence": 0.72 },   // 正解ラベルは「契約」
  "sensitivity":  { "value": "社内",  "confidence": 0.86 },
  "needs_action": { "value": true,    "confidence": 0.99 }
}
ローカルLLMの確信度は、答えの値のトークン確率(logprob)から出した、較正していない参考値です。ルールベースには確信度がありません。
4. 集計用の形(1件×1つのタグで1行)
| 列 |
意味 |
| id / split / type |
文書のID、評価用か開発用か、文書・メール・議事録の別 |
| is_hard / supported / clean |
難問か、本文がラベルを裏付けるか、生成品質の問題がないか |
| axis / label |
タグの名前と、正解の値 |
| 方式ごとの予測 |
ルール、Jev(run0〜run2)、ローカルLLM、カスケードの答え |
| 方式ごとの確信度 |
Jev(3回)とローカルLLMの確信度 |
id,split,axis,label,rule,jev_run0,llm,jev_conf,llm_conf
mail-0011,eval,department,法務,法務,法務,法務,1.00,1.00
mail-0011,eval,project,P35,NONE,P35,NONE,0.83,0.57
mail-0011,eval,doc_kind,契約,契約,連絡,提案,0.72,0.40
mail-0011,eval,sensitivity,社内,機密,社内,社内,0.86,0.58
mail-0011,eval,needs_action,True,True,True,True,0.99,1.00
5. カスケードの規則
for タグ in 5つのタグ:
    if jev[タグ].confidence < 0.5:     # しきい値(開発用で決めた値)
        答え[タグ] = local_llm[タグ]       # 自信がないタグだけ、ローカルLLMに回す
    else:
        答え[タグ] = jev[タグ]
6. SharePointへの書き戻し(次の記事で使う形)
決まったタグは、SharePointの列に書き戻します。Microsoft Graphで、文書1件ごとに次のような値を書き込みます(プロジェクトは複数選択の列なので、型の指定を添えています。環境によっては不要な場合もあるため、実際に使うときは、書き込みの応答で確かめてください)。
PATCH /sites/{site-id}/lists/{list-id}/items/{item-id}/fields
{
  "JevDept": "法務",
  "JevProject@odata.type": "Collection(Edm.String)",
  "JevProject": ["P35"],
  "JevDocType": "連絡",
  "JevSensitivity": "社内",
  "JevActionRequired": true
}
3通りの集計(5軸平均)
| 集計 |
件数 |
ルール |
Jev run0 |
ローカルLLM |
| 全件 |
199 |
85.6% |
90.8% |
87.4% |
| 本文が全軸で支持した件 |
159 |
87.8% |
94.7% |
90.6% |
| 支持した件かつ品質の問題なし |
106 |
87.9% |
95.1% |
90.9% |
正解ラベルの質を絞るほど、全方式の数値が上がります。方式の順位は変わりませんでした。この切り口は分類の後に決めた探索的なものなので、結論の根拠にはしていません。
軸別の正答率(評価用・全件199)
| 軸 |
ルール |
Jev run0 |
ローカルLLM |
カスケード(0.5) |
| 部門 |
84% |
94% |
87% |
94% |
| プロジェクト |
95% |
98% |
96% |
98% |
| 種類 |
74% |
82% |
78% |
82% |
| 機密度 |
91% |
82% |
78% |
81% |
| 機密度(正解が公開の件を除く) |
99% |
89% |
84% |
87% |
| 要対応 |
83% |
96% |
97% |
96% |
| 5軸平均 |
85.6% |
90.8% |
87.4% |
90.5% |
各軸は整数に丸めて表示しています。5軸平均は、丸める前の値から出しているため、表の整数の平均とは0.2〜0.4ずれます。
機密度の混同行列(行=正解、列=予測)
機密度の間違い方
| 方式 |
正解 |
公開 |
社内 |
機密 |
| ルール |
公開(15) |
0 |
14 |
1 |
| ルール |
社内(120) |
0 |
118 |
2 |
| ルール |
機密(64) |
0 |
0 |
64 |
| Jev run0 |
公開(15) |
1 |
13 |
1 |
| Jev run0 |
社内(120) |
0 |
99 |
21 |
| Jev run0 |
機密(64) |
0 |
0 |
64 |
| ローカルLLM |
公開(15) |
1 |
13 |
1 |
| ローカルLLM |
社内(120) |
0 |
90 |
30 |
| ローカルLLM |
機密(64) |
0 |
0 |
64 |
確信度ごとの正答率(Jev run0・全件)
| 軸 |
確信度0.9以上 |
0.9未満 |
| 部門 |
171/172(99%) |
16/27(59%) |
| プロジェクト |
184/186(99%) |
12/13(92%) |
| 種類 |
146/172(85%) |
18/27(67%) |
| 機密度 |
86/89(97%) |
78/110(71%) |
| 要対応 |
173/174(99%) |
19/25(76%) |
ローカルLLMの確信度は、値トークンの確率で、較正していません。
確信度0.9未満の件だけで比べる
| 軸 |
件数 |
Jev run0 |
ローカルLLM |
ルール |
| 部門 |
27 |
59% |
44% |
52% |
| プロジェクト |
13 |
92% |
85% |
92% |
| 種類 |
27 |
67% |
48% |
81% |
| 機密度 |
110 |
71% |
63% |
86% |
| 要対応 |
25 |
76% |
84% |
92% |
Jevが迷う件はローカルLLMも迷い、軸によってはルールのほうが当たりました。ローカルLLMが上回ったのは要対応だけです。
カスケードの上限と実際
「自信がない時だけLLM」は伸びなかった
| しきい値 |
2段目に回した軸 |
上限(2段目が完璧) |
実際(ローカルLLM) |
Jev単独 |
| 0.5(採用) |
5% |
92.6% |
90.5% |
90.8% |
| 0.7 |
12% |
94.4% |
89.7% |
90.8% |
| 0.9 |
20% |
96.7% |
89.0% |
90.8% |
| 0.99 |
42% |
97.9% |
88.6% |
90.8% |
しきい値は、開発用の全件で5軸平均が最も高い0.5に決めました(同点ならローカルLLMに回す割合が小さい方)。評価用の列は参考で、しきい値の選び直しには使っていません。要対応の確信度はmax(p, 1−p)なので0.5未満にならず、しきい値0.5では2段目に回りません。
Jevのばらつき(3回実行)
| 軸 |
各回の正答率 |
全回で予測が一致 |
| 部門 |
94.0 / 94.0 / 94.0% |
199/199 |
| プロジェクト |
98.5 / 98.5 / 98.5% |
199/199 |
| 種類 |
82.4 / 82.9 / 82.4% |
198/199 |
| 機密度 |
82.4 / 82.4 / 81.4% |
194/199 |
| 要対応 |
96.5 / 96.0 / 95.5% |
197/199 |
難問と文書の種類(5軸平均)
| 区分 |
件数 |
ルール |
Jev |
ローカルLLM |
| 難問 |
67 |
85.4% |
91.3% |
88.1% |
| 通常 |
132 |
85.8% |
90.5% |
87.1% |
| 文書 |
67 |
85.4% |
90.4% |
86.3% |
| メール |
66 |
82.7% |
87.0% |
83.3% |
| 議事録 |
66 |
88.8% |
94.8% |
92.7% |
速さと費用(全300件)
| 方式 |
1,000件あたり |
p50 |
p95 |
入力トークン平均 |
| Jev run0 |
$0.2027 |
0.39秒 |
0.48秒 |
4,827 |
| ローカルLLM(Ollama) |
$0 |
3.49秒 |
3.77秒 |
2,829 |
| ルール |
$0 |
0秒 |
0秒 |
0 |
ローカルLLMはローカルのハイエンドGPU(RTX 5080 Laptop)での実測で、GPUのないPCではもっと遅くなります。費用に電気代は含めていません。
長文6件(精度の集計とは別)
- メール3件・議事録3件、本文は約1.4万〜3.8万字。
- Jevの入力には上限があります(公式仕様では、状態と最長の質問で32kトークン)。本文32,178字のメールと38,267字の議事録は、入力が上限を超えて400エラー(max_tokens_exceeded)になり、3回とも失敗しました。
- 処理できた4件では、Jevの3回の結果は同じでした。
- ローカルLLMはnum_ctx 8192のため、長文では入力が約8,200トークンで打ち切られました。
- ルールベースは長さに影響されません。
データ品質
- 合成データの生成で、機械的チェックに12試行でも通らなかった23件(7.7%、上限10%)は、別のラベルの件で補充しました。
- 二次レビュー(30件)との一致率は、5軸合計で97%(146/150)、κは0.82でした。二次レビューは別のClaudeセッションが判定したもので、人手の独立した判定ではありません。
- 品質の問題の例:文書なのに本文が「本メール」になっている、題が「社外向け」なのに本文は社外秘、簡体字の混入。
参考リンク